在工业自动化产线中,工控机通常作为上位机承担设备控制、数据采集与组态显示等任务,处于承上启下的位置。与电机、变频器、可编程控制器等被控设备相比,工控机自身的健康状态往往不在监测范围内,其维护主要依靠人工巡检和故障后抢修。
现场情况表明,工控机的多数故障并非完全突发。CPU 散热能力下降会使温度在数月内缓慢上升;上位机程序长期运行会造成内存占用逐班次增长;磁盘 SMART 信息中的重映射扇区数、待映射扇区数往往在盘体彻底失效前先行增长;内存不足时页错误次数长期偏高。这些征兆在故障发生前就已存在,只是缺少连续采集与分析手段,难以及时发现。
本文介绍成直PHM 系统在某电子制造企业产线的应用情况,说明其现场问题、监测对象界定、系统构成、数据采集实现、预警机制及运行效果。
(1)故障多为突发暴露。上位机在高温季节出现散热不良死机、内存耗尽卡死、磁盘损坏等情况,发现时已造成停机。
(2)缺少趋势数据。人工巡检只记录当前状态,无法判断温度、内存占用等指标的长期变化趋势,难以提前干预。
(3)故障定位困难。上位机死机后缺少故障前的状态记录,排查主要依靠经验判断。
(4)维保过程缺少记录。更换硬盘、清理散热等操作未形成工单,备件与责任追溯困难。
本系统的监测对象是工控机这一计算节点本身,不包括电机、减速机、主轴等被控设备。系统不采集振动、电流、转速信号,也不通过PLC读取设备运行数据。这一界定基于现场分工的考虑:被控设备的机械状态已有振动监测等手段覆盖,而工控机自身的硬件健康状态尚缺乏对应的监测手段,属于运维盲区。
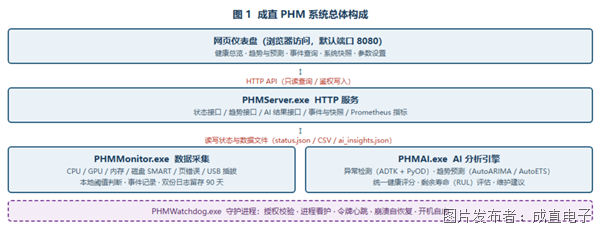
(1)PHMWatchdog 守护进程:负责授权校验、进程看护、令牌心跳与崩溃自恢复。任一模块异常退出后,由其在 1 分钟内重新拉起;系统随操作系统启动自动运行。
(2)PHMMonitor 采集程序:按设定周期采集各硬件指标,执行本地阈值判断并记录事件。
(3)PHMServer HTTP 服务:对外提供状态、趋势、AI 结果、事件与快照等接口,默认监听 8080 端口。
(4)PHMAI AI 引擎:读取采集数据,完成异常检测、趋势预测、剩余寿命评估与维护建议生成。
模块之间以文件为媒介传递数据:采集程序写入CSV 与状态文件,AI 引擎读取 CSV 并输出分析结果,HTTP 服务读取上述文件后对外提供接口,网页仪表盘通过接口获取数据并渲染。采用文件解耦的方式,使各模块可独立升级,也便于故障时单独重启。
温度、SMART(重映射/待映射/不可纠正扇区、磨损、健康分)、读写速率
系统不依赖外接传感器,而是通过操作系统与硬件的标准接口获取数据。以CPU 温度为例,采集按四层顺序回退,流程如图 2 所示:优先读取主板 MSR 寄存器;失败则读取 PDH 性能计数器;再失败则查询 WMI 的主板 ACPI 热区;最后调用硬件传感器程序读取。每一层成功即返回结果并标注数据来源,四层全部失败时将该指标标记为不可用,界面显示“--”,不影响其余指标采集。
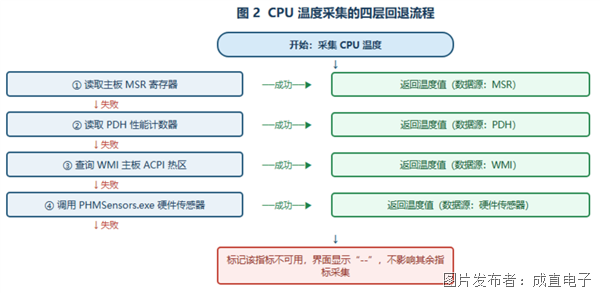
该设计使系统不依赖特定型号的主板或传感器芯片,普通工控机与组装机均可运行,差别仅在于可采集指标的多少。对于现场大量存在的非品牌工控机,回退机制保证了系统的可用性。GPU 温度通过 nvidia-smi 读取,不可用时同样回退;磁盘 SMART 信息通过 WMI 获取。
异常判断在工控机本地完成,数据不必全量上传。这样处理有两个好处:一是外网中断时本地监测与告警不受影响;二是原始数据不必全部传输,节省带宽。
采集数据按日期分文件保存,主数据文件包含53 列、中文表头并带 BOM,可直接用电子表格软件打开;同时在运行目录和日志目录各保存一份,默认留存 90 天,超期自动清理。磁盘日志、退化日志与预测归档分别按分钟、十分钟与小时粒度记录。
系统采用统一的百分制健康评分,由统计检测扣分、硬故障扣分和致命项封顶共同决定。评分分为优秀(≥90)、良好(≥75)、警告(≥60)、退化(≥40)、危险(40)五个等级,每条扣分均给出原因。当 AI 引擎暂时不可用时,系统回退为内置扣分方式,保证评分不中断。
AI 引擎对采集序列进行异常检测,并基于历史数据给出未来 1 小时、4 小时、24 小时的预测值以及 7 天的日级趋势;同时根据退化日志计算关键指标的变化速率,估算其达到告警限值所需时间,即剩余寿命(RUL),并给出风险等级。
趋势预测需要一定长度的历史数据。系统在数据不足时保留空白而不输出推测值:投产初期约一到两个月以状态监测为主;退化日志不足7 天时,剩余寿命显示为“数据积累中”。该策略避免了在样本不足时给出误导性结论。
(1)持续时长门控:指标超过阈值并持续一定时间后才触发告警,滤除瞬时波动。
(2)递增冷却:同类告警触发后,冷却时间由 5 分钟逐级延长至 2 小时;确需升级时可通过特定标志绕过冷却。
(3)合并通知:告警在环形缓冲区中合并后统一推送至桌面通知与事件页面,避免逐条弹出。
告警触发后可生成维保工单,记录指派人员、备件更换与检修结果,使“发现异常”到“完成维修”的过程可追溯。这一环节使系统区别于仅提供报警的单点监测工具。
系统部署于该企业产线的上位机,采用安装程序方式部署,随操作系统启动自动运行。部署前使用配套体检工具检查运行环境,确认无错误项后投入运行。系统运行界面如图3 所示。
(1)连续监测替代人工巡检。系统以 15 秒周期采集硬件状态,覆盖人工巡检难以持续观察的温度、SMART 等指标。
(2)趋势数据支持提前干预。以固态盘为例,其磨损度与健康分的变化趋势可用于估算剩余可用时间,为备件准备提供依据。
(3)预警链路得到验证。运行期间系统根据 92 % 的磁盘占用率触发“注意偏高”告警,提示清理日志文件,处置过程中未影响生产。
(4)维保过程可追溯。告警与工单关联记录,更换备件与检修结果可事后查询。
本文介绍了面向工控机主机的预测性维护系统在某电子制造企业产线的应用。系统通过系统级接口采集CPU、GPU、内存、磁盘 SMART 等硬件状态,在本地完成异常判断,结合趋势预测与剩余寿命评估生成分级告警与维保工单。现场运行表明,该方案能够覆盖人工巡检难以持续观察的指标,为工控机的维护提供数据支持,适用于将工控机作为关键上位机的产线场景。
需要说明的是,本系统的适用范围限于工控机主机本身。被控设备的机械状态监测、预测模型精度提升所需的故障样本积累,以及现场运维制度的配合,仍是系统发挥作用的前提条件。